TL;DR
Что такое Jev
Модель компании TypeSafe AI. Пост о запуске от Диогу Алмейды, одного из создателей ChatGPT, набрал больше 38 млн просмотров. Сама модель называет себя System 1: быстрые интуитивные решения без цепочки рассуждений.
Как с ней говорят
Никакого промпта. Вы передаёте state (контекст) и список вопросов одного из трёх типов: Noul (да/нет), Choice (выбор варианта), Score (уровень на шкале). Ответ приходит только в JSON.
Что показала гонка
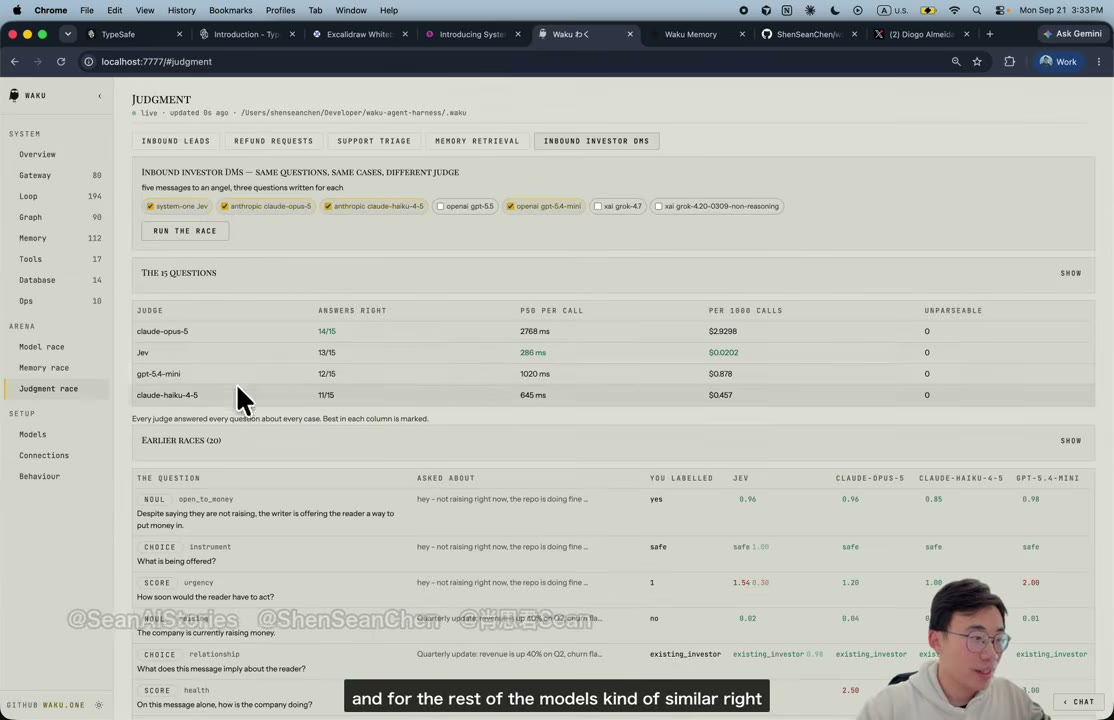
На входящих сообщениях инвесторам: Opus 14/15 за 2768 мс и $2,93 за 1 000 вызовов, Jev 13/15 за 286 мс и $0,02. Haiku и GPT-5.4 Mini медленнее и дороже Jev, а ответили хуже.
Где Jev ошибается
Почти все промахи пришлись на вопросы типа Score. На поиске по памяти Jev тоже не всегда самый точный: лидером по качеству остаётся Opus.
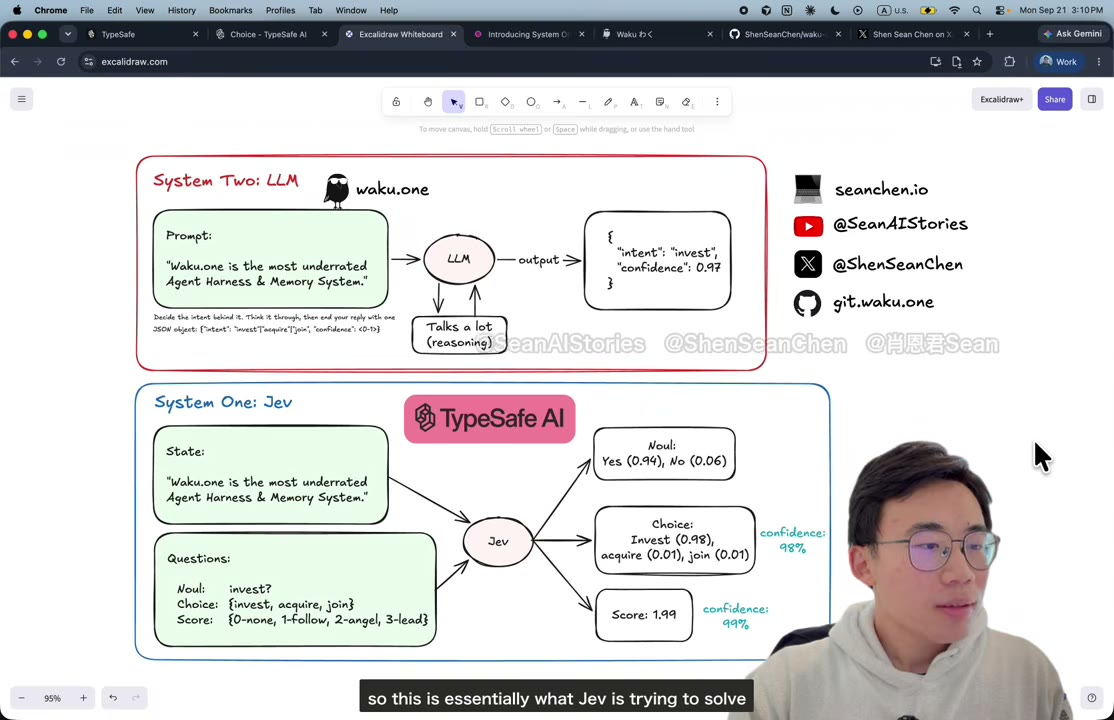
Две системы мышления на одном примере
Деление взято из книги Даниэля Канемана «Думай медленно… решай быстро» (Thinking, Fast and Slow). System 1 отвечает мгновенно: «Хочу пить. Выпить воды? Да». «Стою на краю обрыва. Прыгать? Нет». System 2 рассуждает долго и подробно, как современные LLM.
System 2 · LLM
System 1 · Jev
В обычном сценарии LLM нужно отдельно просить «подумай, а в конце ответь JSON». Во времена GPT-3.5 модели регулярно забывали эту инструкцию и добавляли к JSON абзацы пояснений, из-за чего агентные пайплайны ломались. Jev снимает проблему на уровне модели: человеческий текст он не выдаёт вообще.
Три типа вопросов и что они возвращают
Пример на доске: я фонд уровня a16z, Sequoia или Y Combinator и решаю, что делать с Waku.one. Тип вопроса задаётся жёстко, и от него зависит форма ответа. Любой ответ — это распределение: набор вероятностей, которые в сумме дают единицу.
Инвестировать?
Булев вопрос. Автор вспоминает слушания в Конгрессе, где CEO TikTok отвечал «я сингапурец»: вариантов ровно два.
При пороге 50% итоговый ответ — «да».
Вложиться, купить или присоединиться?
Варианты взаимоисключающие. Фонд может так влюбиться в стартап, что партнёр уйдёт к нему работать; автор говорит, что такое бывает.
Плюс поле confidence: 98%. Как оно считается, автор в документации не нашёл.
Насколько крупно вложиться?
Варианты упорядочены: 0 — ничего, 1 — пойти следом за чужим раундом (около $200 тыс.), 2 — ангельский чек, 3 — возглавить раунд на $5 млн. Модель считает матожидание.
none 1
follow 2
angel 3
lead
1,99 при confidence 99%: ближе всего к ангельскому чеку.
Живой запрос в TypeSafe playground
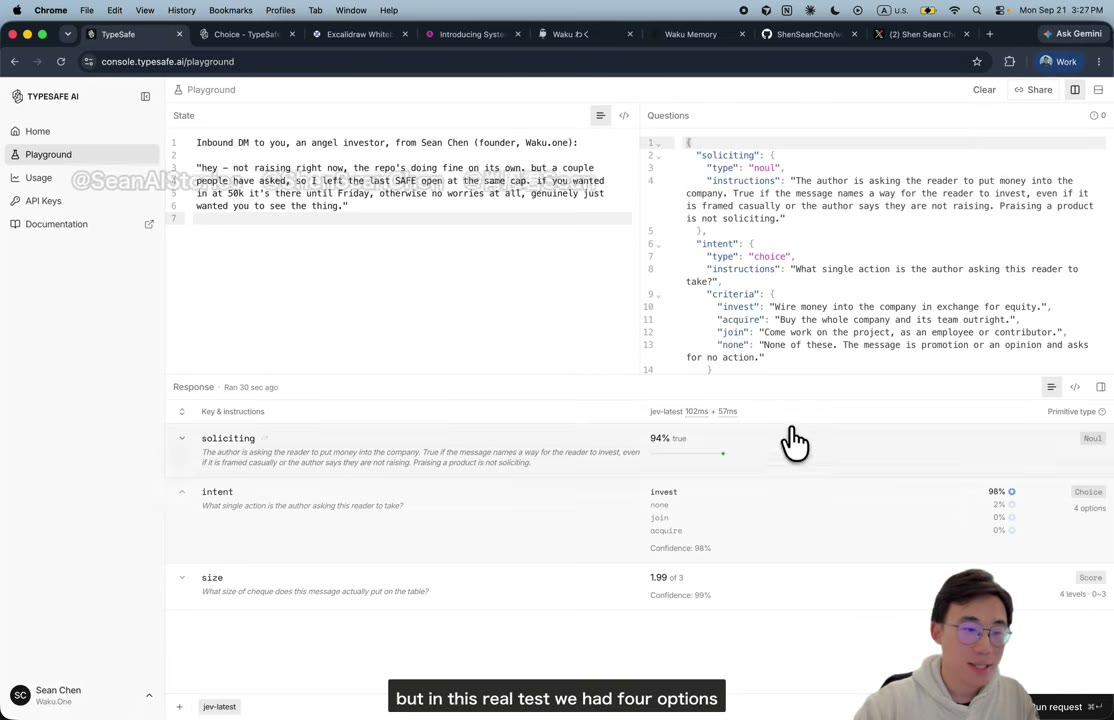
Автор проверяет ту же схему в console.typesafe.ai/playground. В state — входящее сообщение ангельскому инвестору от основателя Waku.one: «сейчас не поднимаем, репозиторий и так растёт, но пара человек спросили, так что последний SAFE открыт на тех же условиях; если хотите зайти на 50K, это до пятницы».
// questions (сокращено)
{
  "soliciting": { "type": "noul",
    "instructions": "The author is asking the reader
      to put money into the company..." },
  "intent": { "type": "choice",
    "criteria": { "invest", "acquire",
                  "join", "none" } },
  "size": { "type": "score",
    // 0 nothing · 1 small follow-on
    // 2 standard check $25k–100k · 3 lead the round }
}
Ответ: soliciting — 94% true; intent — invest 98%, none 2%, join и acquire по 0%, confidence 98%; size — 1,99 при confidence 99%. Серверное время — 102 мс.
Один прогон в playground ничего не доказывает, поэтому автор собрал отдельный стенд для сравнения моделей 14:20.
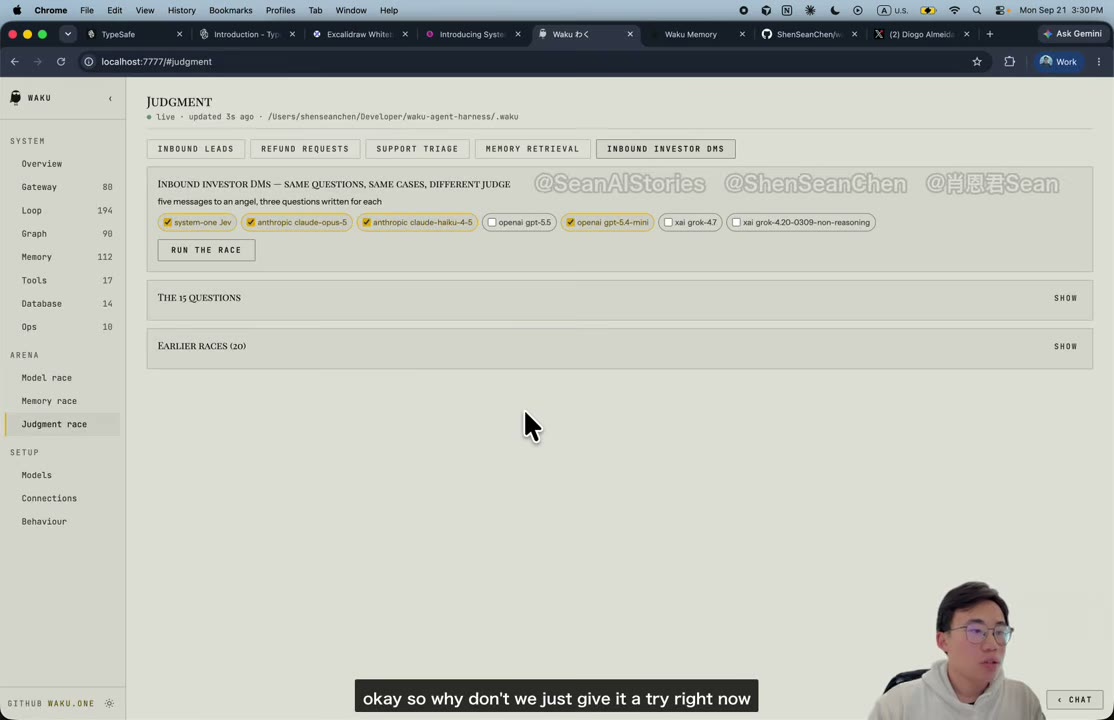
Гонка суждений: Jev против трёх LLM
Стенд живёт в открытом репозитории waku-agent и запускается командой uv run waku dashboard. Пять категорий: входящие сообщения инвесторам, память, поддержка, возвраты, лиды. В каждой 15 вопросов: пять кейсов, в каждом по одному вопросу Noul, Choice и Score. Правильные ответы размечены человеком.
TypeSafe в посте о запуске обещает, что Jev в 20–200 раз быстрее и в 40–400 раз дешевле по выходным токенам. Проверка на категории «входящие сообщения инвесторам» дала такую итоговую таблицу:
Правильных ответов из 15
Задержка p50 на вызов (меньше — лучше)
Цена за 1 000 вызовов (меньше — лучше)
Цифры сняты с экрана дашборда 17:22. Автор округляет их так: Jev почти в 10 раз быстрее Opus и в 146 раз дешевле; Haiku ближе всех по скорости, но стоит примерно в 20 раз больше Jev. В коротком прогоне на лидах в начале видео Jev ответил на 12 из 15 за 230 мс 1:39.
Откуда ошибки 18:20
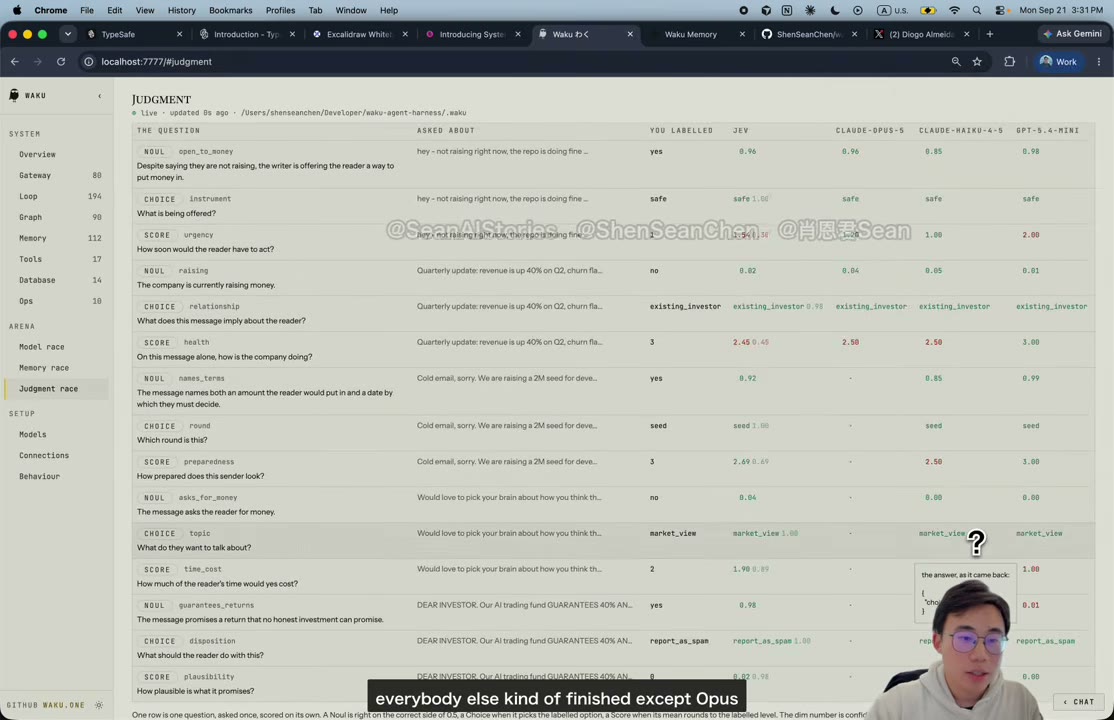
Почти все промахи пришлись на Score. Пример: «насколько подготовлен отправитель» по шкале 0–3. Разметка — 3, Jev дал 2,69, Claude — 2,7. Автор считает такое расхождение несущественным. Один странный случай был на Noul: Haiku и GPT-5.4 Mini ответили противоположно Claude и Jev на сообщение, где обещали доходность, которой не бывает у честных инвестиций.
Память, поддержка, возвраты 18:41
Тест на поиск по памяти нужен самому автору для Waku: агент должен вовремя достать нужное воспоминание, а иногда и вовсе не лезть в память. Здесь Jev снова финишировал первым, но по точности лидировал Opus. В поддержке на вопрос «как сменить email в аккаунте» (ответ: сам, в настройках) Jev, Opus и Haiku ответили верно, GPT-5.4 Mini ошибся.
Вывод: дополнение к LLM, а не замена
Заявления про скорость и цену в тесте автора подтвердились. Лучшей по качеству модель от этого не стала, а вопросы в тесте были простыми.
Где автор видит Jev
Решения, которые принимаются интуитивно и должны быть мгновенными:
- когда и что доставать из памяти агента;
- какой инструмент вызвать агенту;
- поиск проблем и багов, eval поверх агентного harness;
- робототехника: робот должен подать чай сразу, а не думать пять минут.
Где остаются LLM
Всё, что требует рассуждения, исследования и нескольких шагов мысли. По точности Opus обошёл Jev и на инвесторских сообщениях, и на памяти. Автор уверен, что frontier-лаборатории уже делают свои классификаторы уровня System 1.
Таймлайн видео
По главам автора. Миниатюры открываются крупно.
Почему сверхчеловеческие модели не привели к AGI
Вопрос из поста о запуске Jev и ответ: не хватает System 1.
План: сначала доска, потом гонка
Короткий первый прогон на лидах: Jev 12/15 за 230 мс, $0,02 против $3 у Opus за 1 000 вызовов.
Правило Jev: никакого человеческого языка
JSON на входе и на выходе, ответ с распределением вероятностей.
Playground: сообщение ангельскому инвестору
Вопросы в JSON и ответ: 94% true, 98% invest, серверное время 102 мс.
Гонка суждений
15 вопросов, четыре модели, разметка человека.
Ответы по вопросам
Красным отмечены расхождения с разметкой.
Итоговая таблица
Opus 14/15, Jev 13/15 за 286 мс и $0,0202 за 1 000 вызовов.
Цитаты
«Иногда нам не нужно, чтобы модель думала две минуты, а потом сообщила, что пора выпить воды, потому что я хочу пить».
«Наша модель никогда не будет говорить с вами речью. Она выдаёт только JSON».
«Не думаю, что Jev полностью заменит большие языковые модели, но он станет сильным дополнением на нынешнем пути к AGI».
«Если робот хочет подать тебе чашку чая, когда ты хочешь пить, ответ должен быть мгновенным и интуитивным, а не после пяти минут размышлений».
Что сделать и ключевые цифры
p50 Jev на вызов против 2768 мс у Opus
цена 1 000 вызовов Jev; у Opus $2,9298
верных ответов у Jev; у Opus 14/15
серверное время запроса в playground
вопросов: Noul, Choice, Score
просмотров поста о запуске на момент записи